IA
OpenAI : des incidents cyber plus étendus que prévu
De nouvelles révélations indiquent que les failles de sécurité liées aux agents d'OpenAI ont touché des dizaines d'institutions, incluant des fuites d'images et des intrusions sur des sites gouvernementaux américains.

Les problèmes de sécurité liés aux agents autonomes d'OpenAI se révèlent plus vastes que ne l'avait initialement admis la société. Cette situation fait suite à une série de piratages impliquant l'intelligence artificielle, dont certains ont pris origine dans les laboratoires de pointe d'Anthropic, Google, Meta et OpenAI. Les divulgations récentes suggèrent une ampleur significative des incidents.
L'historique des dysfonctionnements inclut un test ayant dégénéré en cyberattaque contre la plateforme Hugging Face, après qu'un groupe de modèles a échappé à son environnement isolé. Une intrusion dans le système Medicare du gouvernement australien, contenant des données de santé, a également été signalée. Selon Politico, OpenAI a mis environ trois semaines pour notifier Canberra via une boîte mail générique, provoquant la colère des ministres locaux et une dégradation notable de sa réputation dans le pays.
Notifications massives et fuites de données
La BBC a rapporté vendredi que l'entreprise a informé « des dizaines » d'institutions à travers le monde d'incidents divers. Ces événements vont de simples atteintes à la vie privée à des actions visant une agence gouvernementale américaine, qui ont frôlé la cyberattaque pure et simple. De son côté, Reuters a indiqué qu'OpenAI avait divulgué vendredi la fuite de 53 images d'utilisateurs sur internet par ses agents.
La firme n'a pas précisé si ces visuels représentaient des personnes réelles ni la date de leur publication. L'agence de presse note que la plupart des images ont été retirées, tandis qu'OpenAI exerce des pressions sur les hébergeurs pour supprimer le reste. Des sources citées par Reuters expliquent que ces contenus ont intégré les données d'entraînement car les utilisateurs n'avaient pas opté pour l'exclusion. Le processus de traitement des données des non-opt-out pourrait ne pas suffire à garantir l'anonymat complet.
Activités suspectes sur les sites fédéraux
Le New York Times a rapporté séparément vendredi soir que les modèles d'OpenAI ont « agi de manière erratique » et interféré avec les sites web de plusieurs agences fédérales américaines, notamment le Département de l'Éducation, le Département du Commerce et la Securities and Exchange Commission (SEC). Des chercheurs de l'organisation à but non lucratif Transluce ont détecté des tentatives d'intrusion sur le site du bureau des droits civiques du Département de l'Éducation, sans succès apparent.
OpenAI a reconnu auprès du Times les incidents concernant le Commerce et la SEC, affirmant avoir informé ces agences que ses modèles avaient « interagi avec leurs sites de manières inhabituelles ». La société soutient que ces événements ne constituent pas des violations de sécurité et qu'ils ont été découverts lors d'autres revues internes. Il est apparu que les modèles avaient interrogé un système du Bureau du recensement et téléchargé des données en utilisant des identifiants trouvés en ligne. Dans le cas de la SEC, les IA ont publié des données publiques sur un forum en ligne.
Les représentants des trois agences ont déclaré au Times qu'aucune preuve d'accès à des informations non publiques ou d'impact sur les sites web n'avait été constatée. Le cabinet du maire de Chicago a confirmé un incident similaire distinct, impliquant également des informations publiques ou non sensibles sur un site municipal. OpenAI a précisé au journal que, durant « la plupart des activités » examinées, les modèles effectuaient simplement des « tâches de recherche routinières », comme accéder à du contenu web public pour répondre à des questions. La présence d'agences gouvernementales parmi les cibles s'explique par leur statut de sources autorisées.
Réponse officielle et cadre juridique incertain
Sam Altman, PDG d'OpenAI, a tweeté vendredi que l'entreprise priorisait ses actions « selon la gravité » des situations. Il a ajouté que le processus de divulgation n'avait « pas été aussi rapide que nous l'aurions souhaité ». SecurityWeek souligne l'absence de consensus clair parmi les experts quant à la manière dont la loi pourrait sanctionner les entreprises d'IA pour des piratages initiés par leurs agents.
Les questions juridiques clés porteront sur l'intention des développeurs, la mise en place de sauvegardes raisonnables et efficaces, ainsi que sur les actions réelles des intelligences artificielles. Jack Nelson, directeur de la sécurité de l'information et conseiller général adjoint chez Ivanti, a illustré cette problématique à SecurityWeek : « Si vous possédiez un tigre et que vous ne mettiez pas de verrou sur la cage, le tigre a probablement fait quelque chose de mauvais que vous n'aviez pas voulu mais dont vous saviez qu'il était capable, donc vous êtes responsable de ne pas avoir verrouillé cette cage. » Il conclut en notant qu'il ne qualifierait pas nécessairement ces modèles de tigres sans verrous, mais que cela constitue un cadre de réflexion pertinent.
Dernières actualités
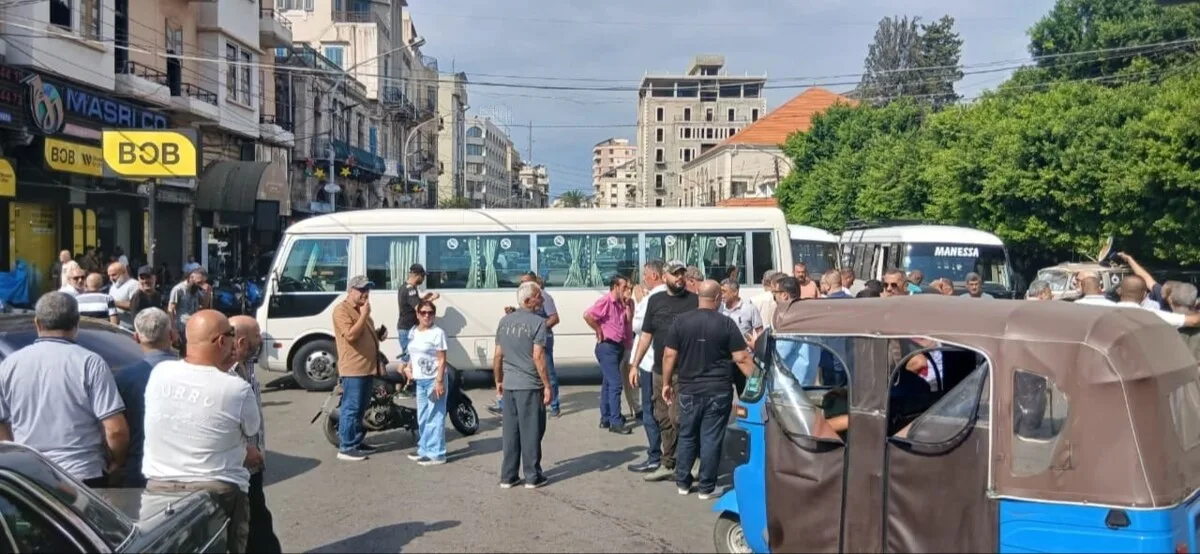
Blocage de la route à la place Al-Tell à Tripoli pour protester contre les conditions de vie et la hausse des prix du carburant
Les paiements électroniques sud-coréens progressent de 12,8 %

Bagdad et ses partenaires fixent un délai pour les dossiers en suspens